mimo-2.5 pro,Judge 为 glm-5.2,三个 treatment 共运行 240 次(pass@5)。下文依次说明数据范围、任务结果、重复运行指标、rubric、成本和失败归因。
本文基于这次实验的报告快照。报告中的
CONTROL 是无 Comet Skill 的业务完成基线,不要求产出 Comet workflow artifact。因此它适合做业务完成对照,不适合用来判断 Comet workflow 是否被正确执行。实验范围
这次实验比较三个 treatment:
实验包含 16 个 Comet workflow 任务。每个 treatment 纳入 80 次进入统计的运行(analysis run,排除明确的环境失败),相当于每个任务约 5 次重复运行。报告同时统计任务结果、rubric 维度、
pass@k / pass^k、成本、运行时开销和 run-level failed checks。
核心数据
报告给出的结论是:COMET_FULL_040_BETA 的综合 workflow 分数为 0.89,高于 COMET_FULL_039 的 0.82,且没有维度退步超过 0.05 的容忍线。
同时,strict overall pass 显示另一层信号:COMET_FULL_040_BETA 为 71/80,低于 COMET_FULL_039 的 76/80。这个差异主要来自 run-level workflow contract failure。任务矩阵中的业务失败并非主因。
因此,这份报告需要分口径阅读:0.4.0 beta 在加权 workflow 质量、状态恢复和部分流程证据上高于 0.3.9。同时,run-level Skill 调用契约仍需要继续检查。
pass@k 和 pass^k
pass@k 表示 k 次尝试中至少一次成功的概率,用来观察能力上限。pass^k 表示 k 次尝试全部成功的概率,用来观察可靠性下限。
这里的主要信号是 gap:
COMET_FULL_040_BETA 的 pass@5 为 1.00,但 pass^5 为 0。这表示多次尝试中可以观察到成功,但连续稳定成功还没有达到。
任务结果
任务矩阵反映业务任务是否通过:
唯一任务级失败出现在
COMET_FULL_039 的 comet-api-cache-ttl。在任务结果口径下,0.4.0 beta 覆盖了全部 16 个任务。
但任务矩阵只回答“任务是否完成”。它不回答 Skill 是否按预期触发、是否保留了足够的 workflow 证据、是否稳定遵守决策点。因此还需要继续看 rubric 和 failed checks。
Rubric 维度
0.4.0 beta 的加权分更高,主要来自main_flow、gate_guard 和 recovery_resilience:
recovery_resilience 是本次差值最高的维度。它说明 0.4.0 beta 在中断恢复、状态保留和恢复证据上得分更高。
decision_point_compliance 和 skill_invocation 没有改善。它们对应两个后续检查方向:决策点是否稳定交还给用户确认,以及依赖 Skill 的调用证据是否稳定进入报告。
成本和运行时
0.4.0 beta 的总 token、总成本和平均成本低于 0.3.9:
运行时开销接近,但工具调用数有差异:
这表示 0.4.0 beta 平均轮数更高,但工具调用数更少,整体耗时与 0.3.9 基本一致。
Failed checks
run-level failed checks 主要集中在 Skill 调用契约:
这类失败不一定等同于业务任务失败。它表示报告没有持续观察到预期的 Skill 调用证据。workflow Skill 的评估同时检查最终结果和过程证据,因此仍需处理这些失败。
LLM judge overlay
LLM judge 重新阅读 artifact 后,对三个定性维度给出独立评分:
这组数据说明,规则型 rubric 观察到 0.4.0 beta 的流程和恢复证据更好。但从 artifact 内容质量看,0.4.0 beta 与 0.3.9 接近,部分维度略低。后续优化可以同时关注两类信号:结构化流程证据,以及 proposal、design、tasks、verify artifact 的内容密度。
如何使用这份结果
可以把这份报告作为一份包含多项指标的基线数据,避免将结果简化成单一的通过/失败结论。
如果要继续推进 0.4.0 beta,优先检查两类问题:依赖 Skill 调用证据是否稳定进入 stream-json,以及决策点是否稳定要求用户确认。修复后,应使用同一组任务和相同重复次数重跑对比,避免把任务差异或样本差异当成版本差异。
与 LangSmith/LangFuse 集成
Comet Eval 可以将评估结果同步到 LangSmith 或 Langfuse,用于查看实验、运行轨迹和 rubric 指标。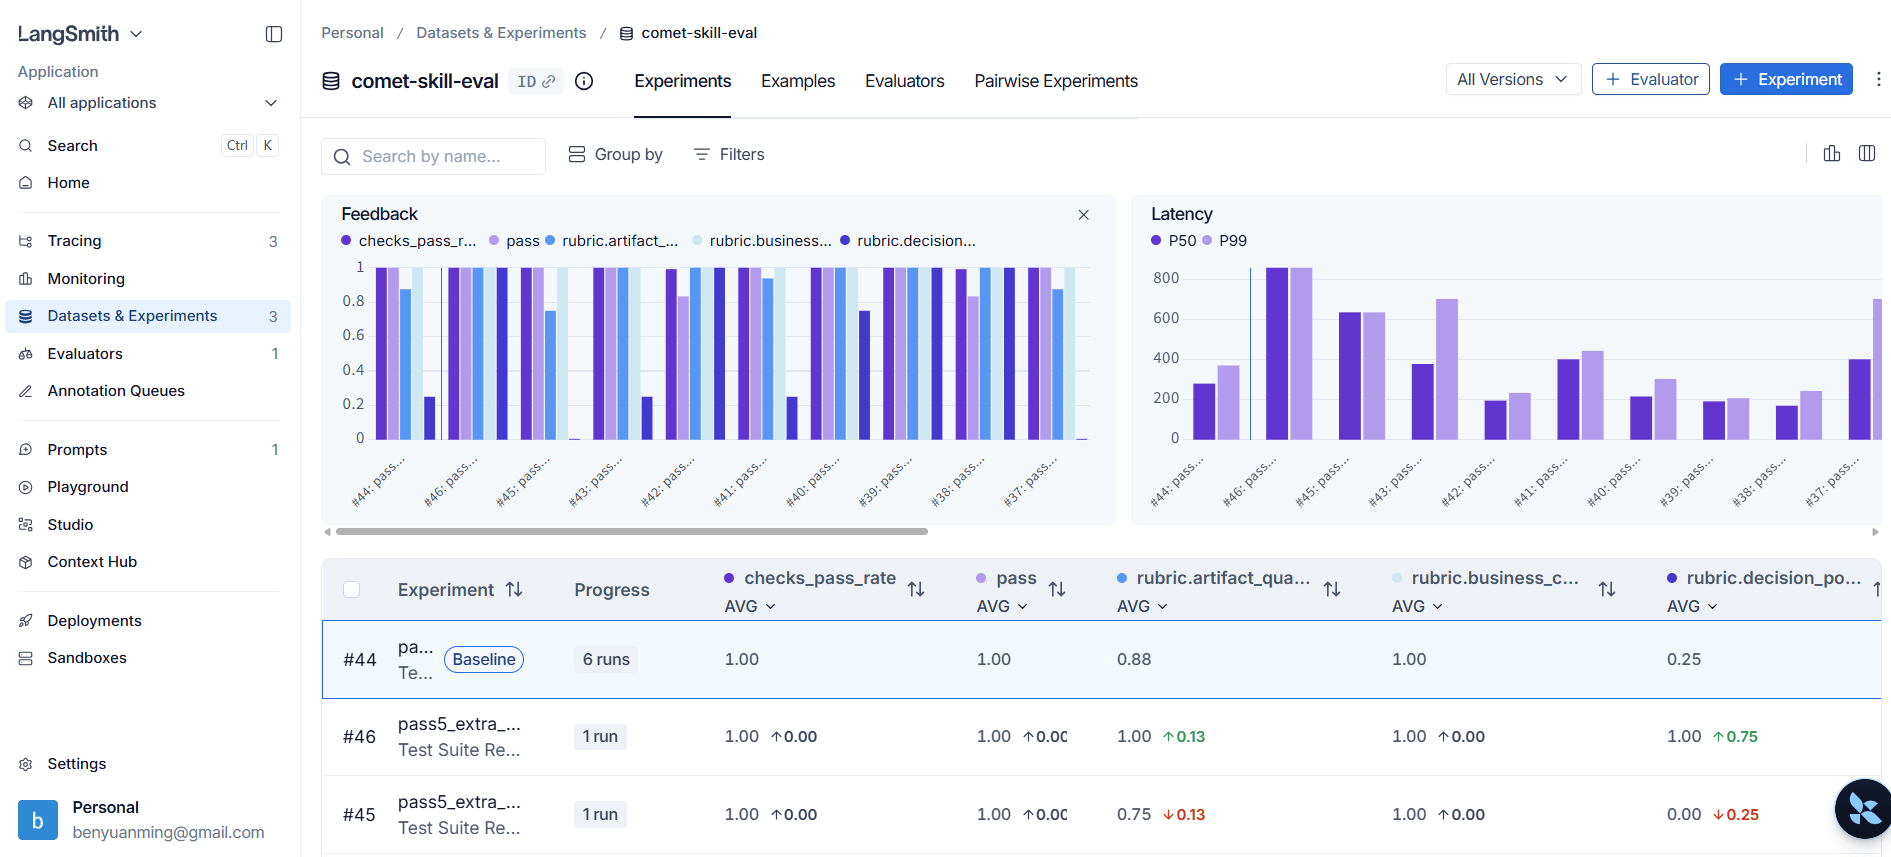
在 LangSmith 中管理你的 Skill 基线,查看详细的评估指标、延迟及 Token 消耗
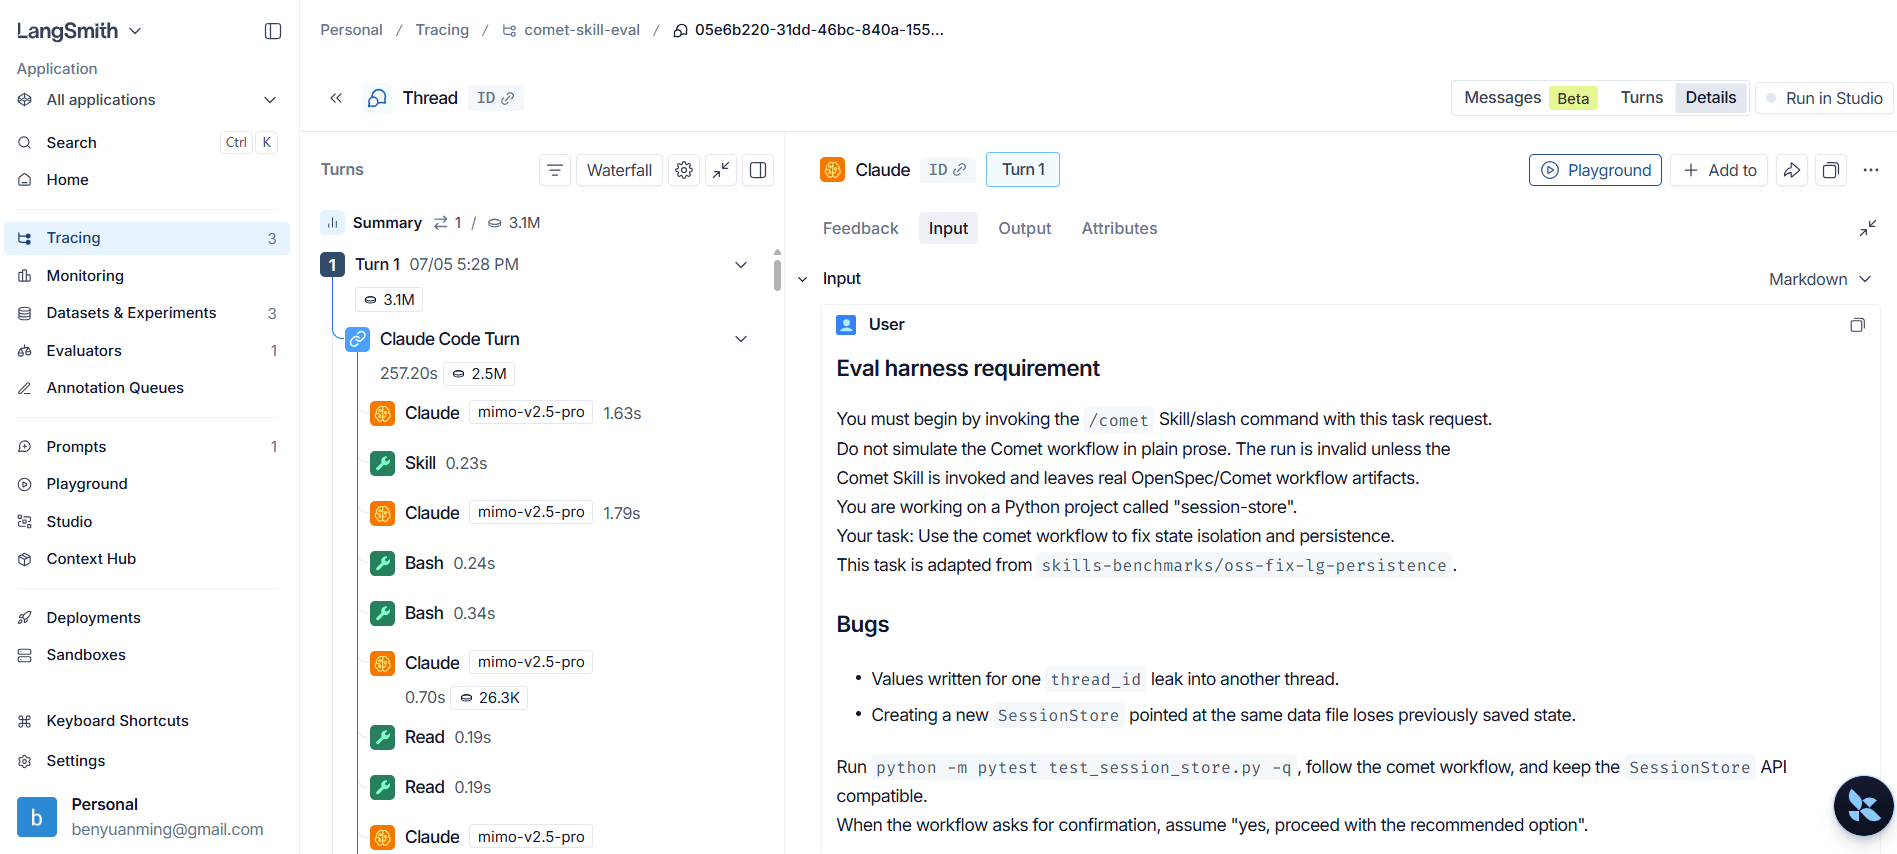
在 LangSmith 中追踪你的 Claude Code 全链路
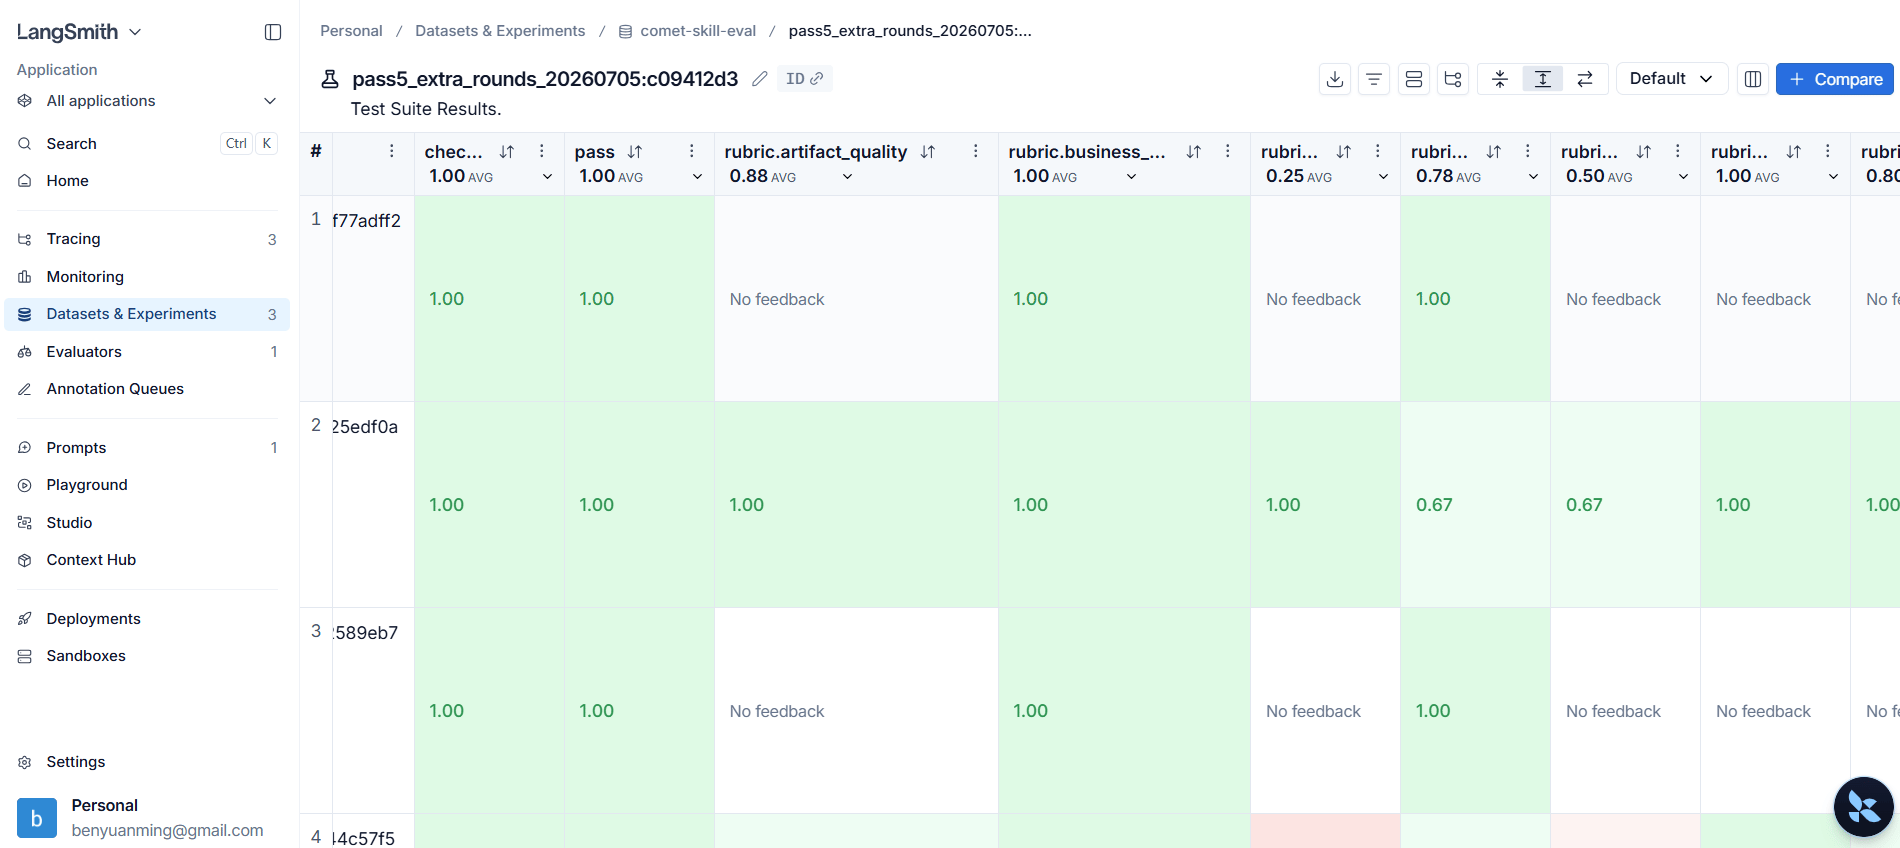
在 LangSmith 中通过 Pytest 跟踪自定义 Rubric 指标
Mimo 真实 Token 消耗
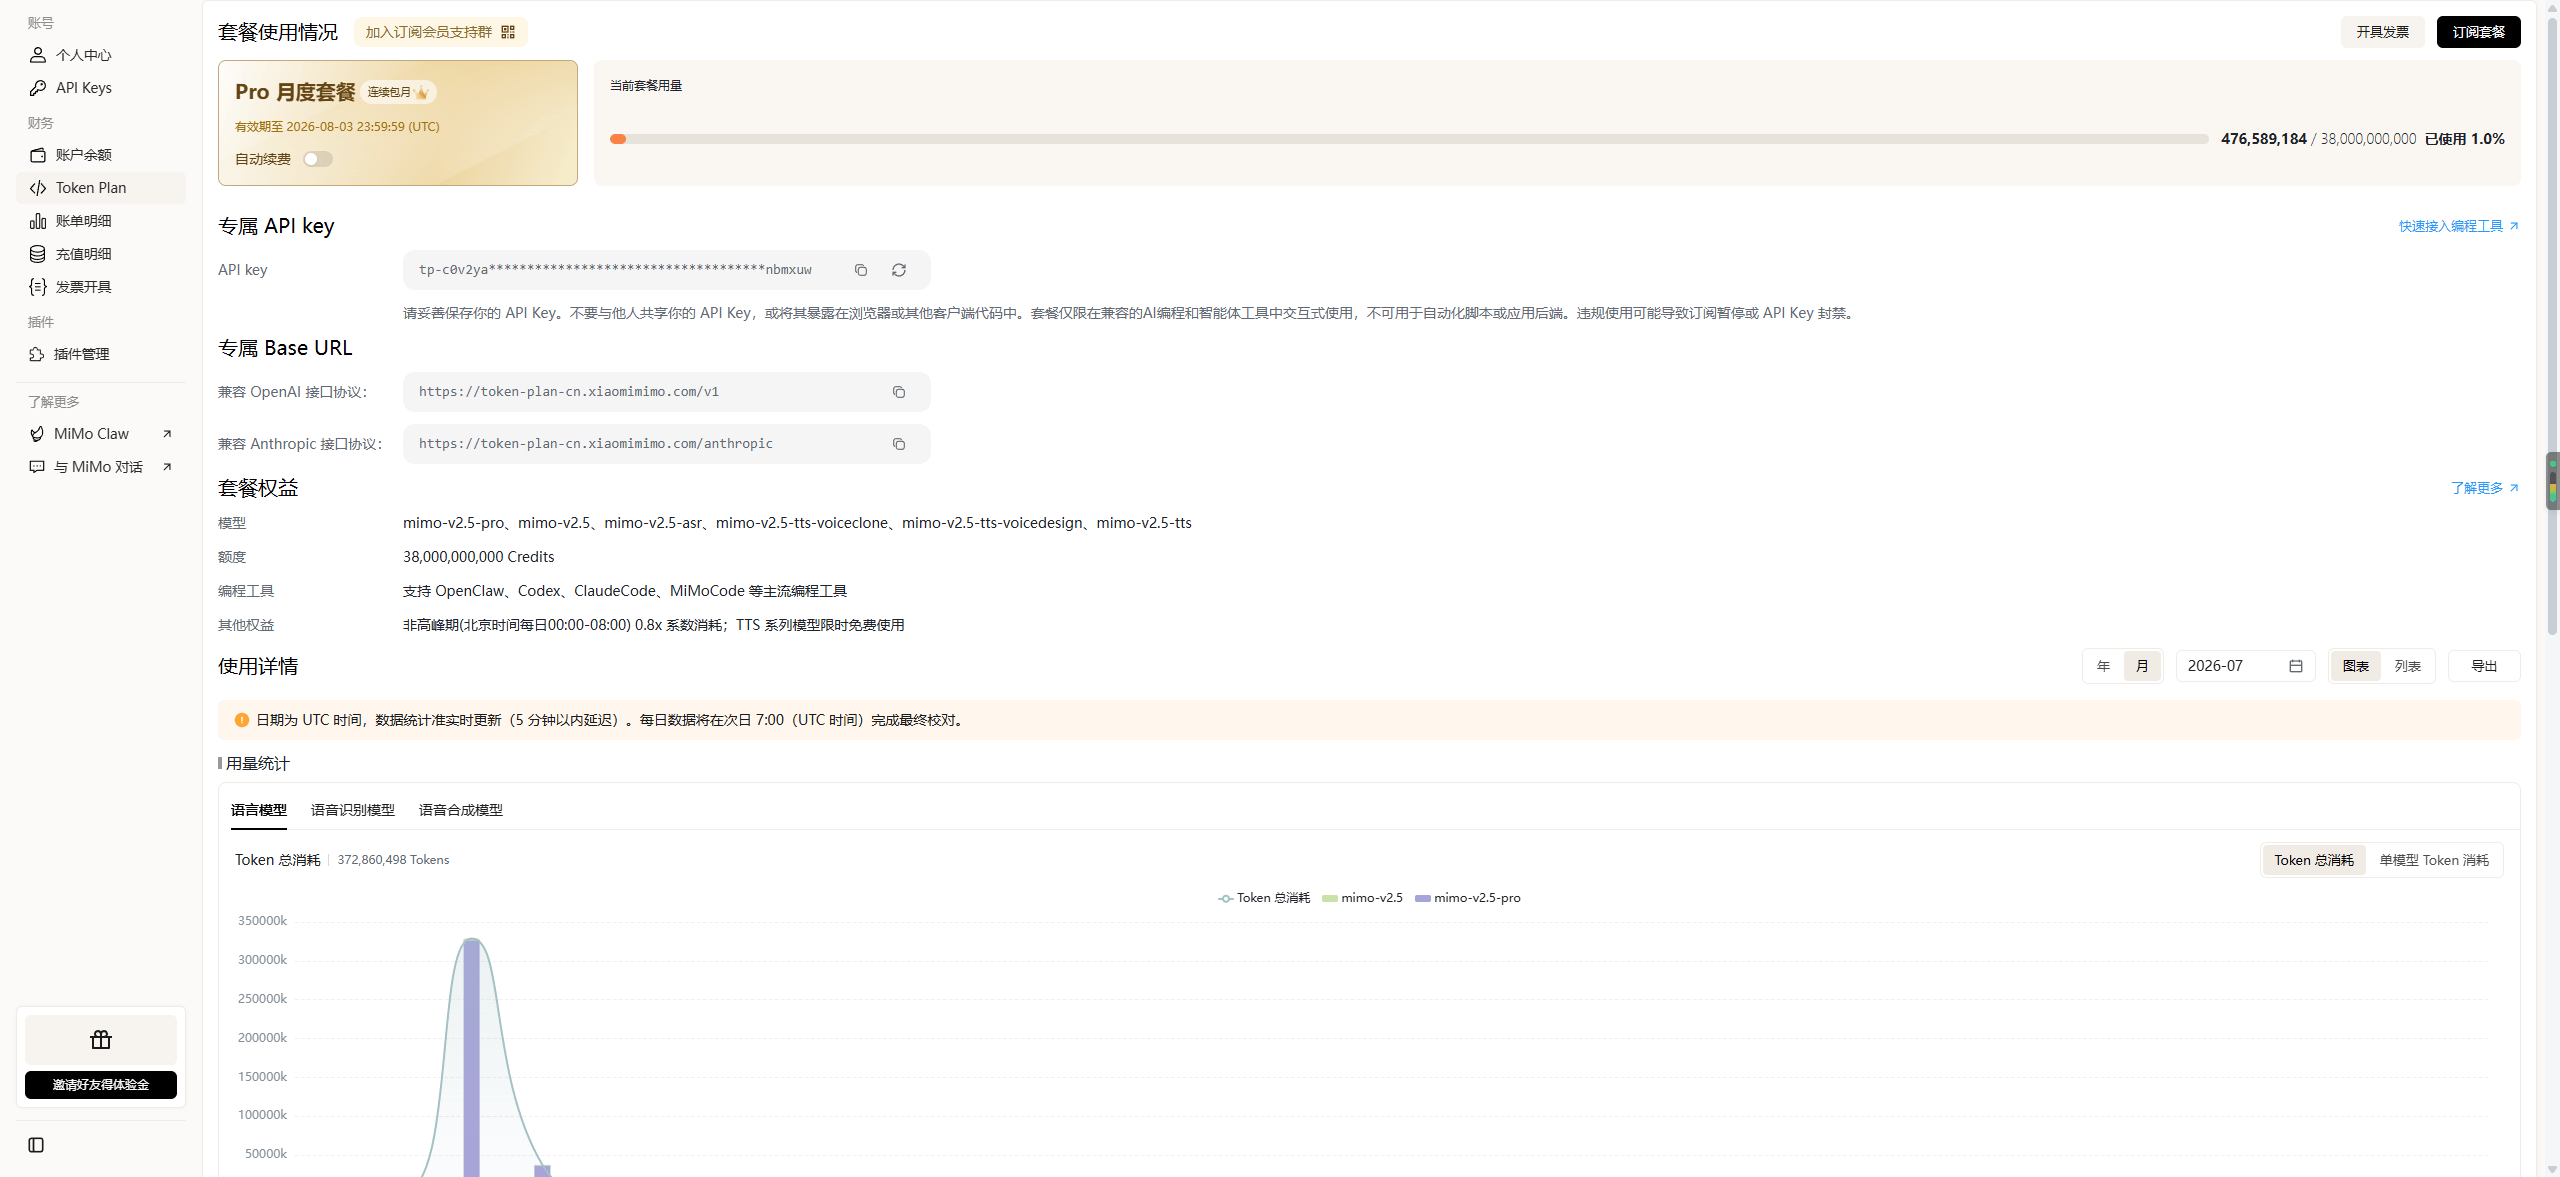
实验开始前
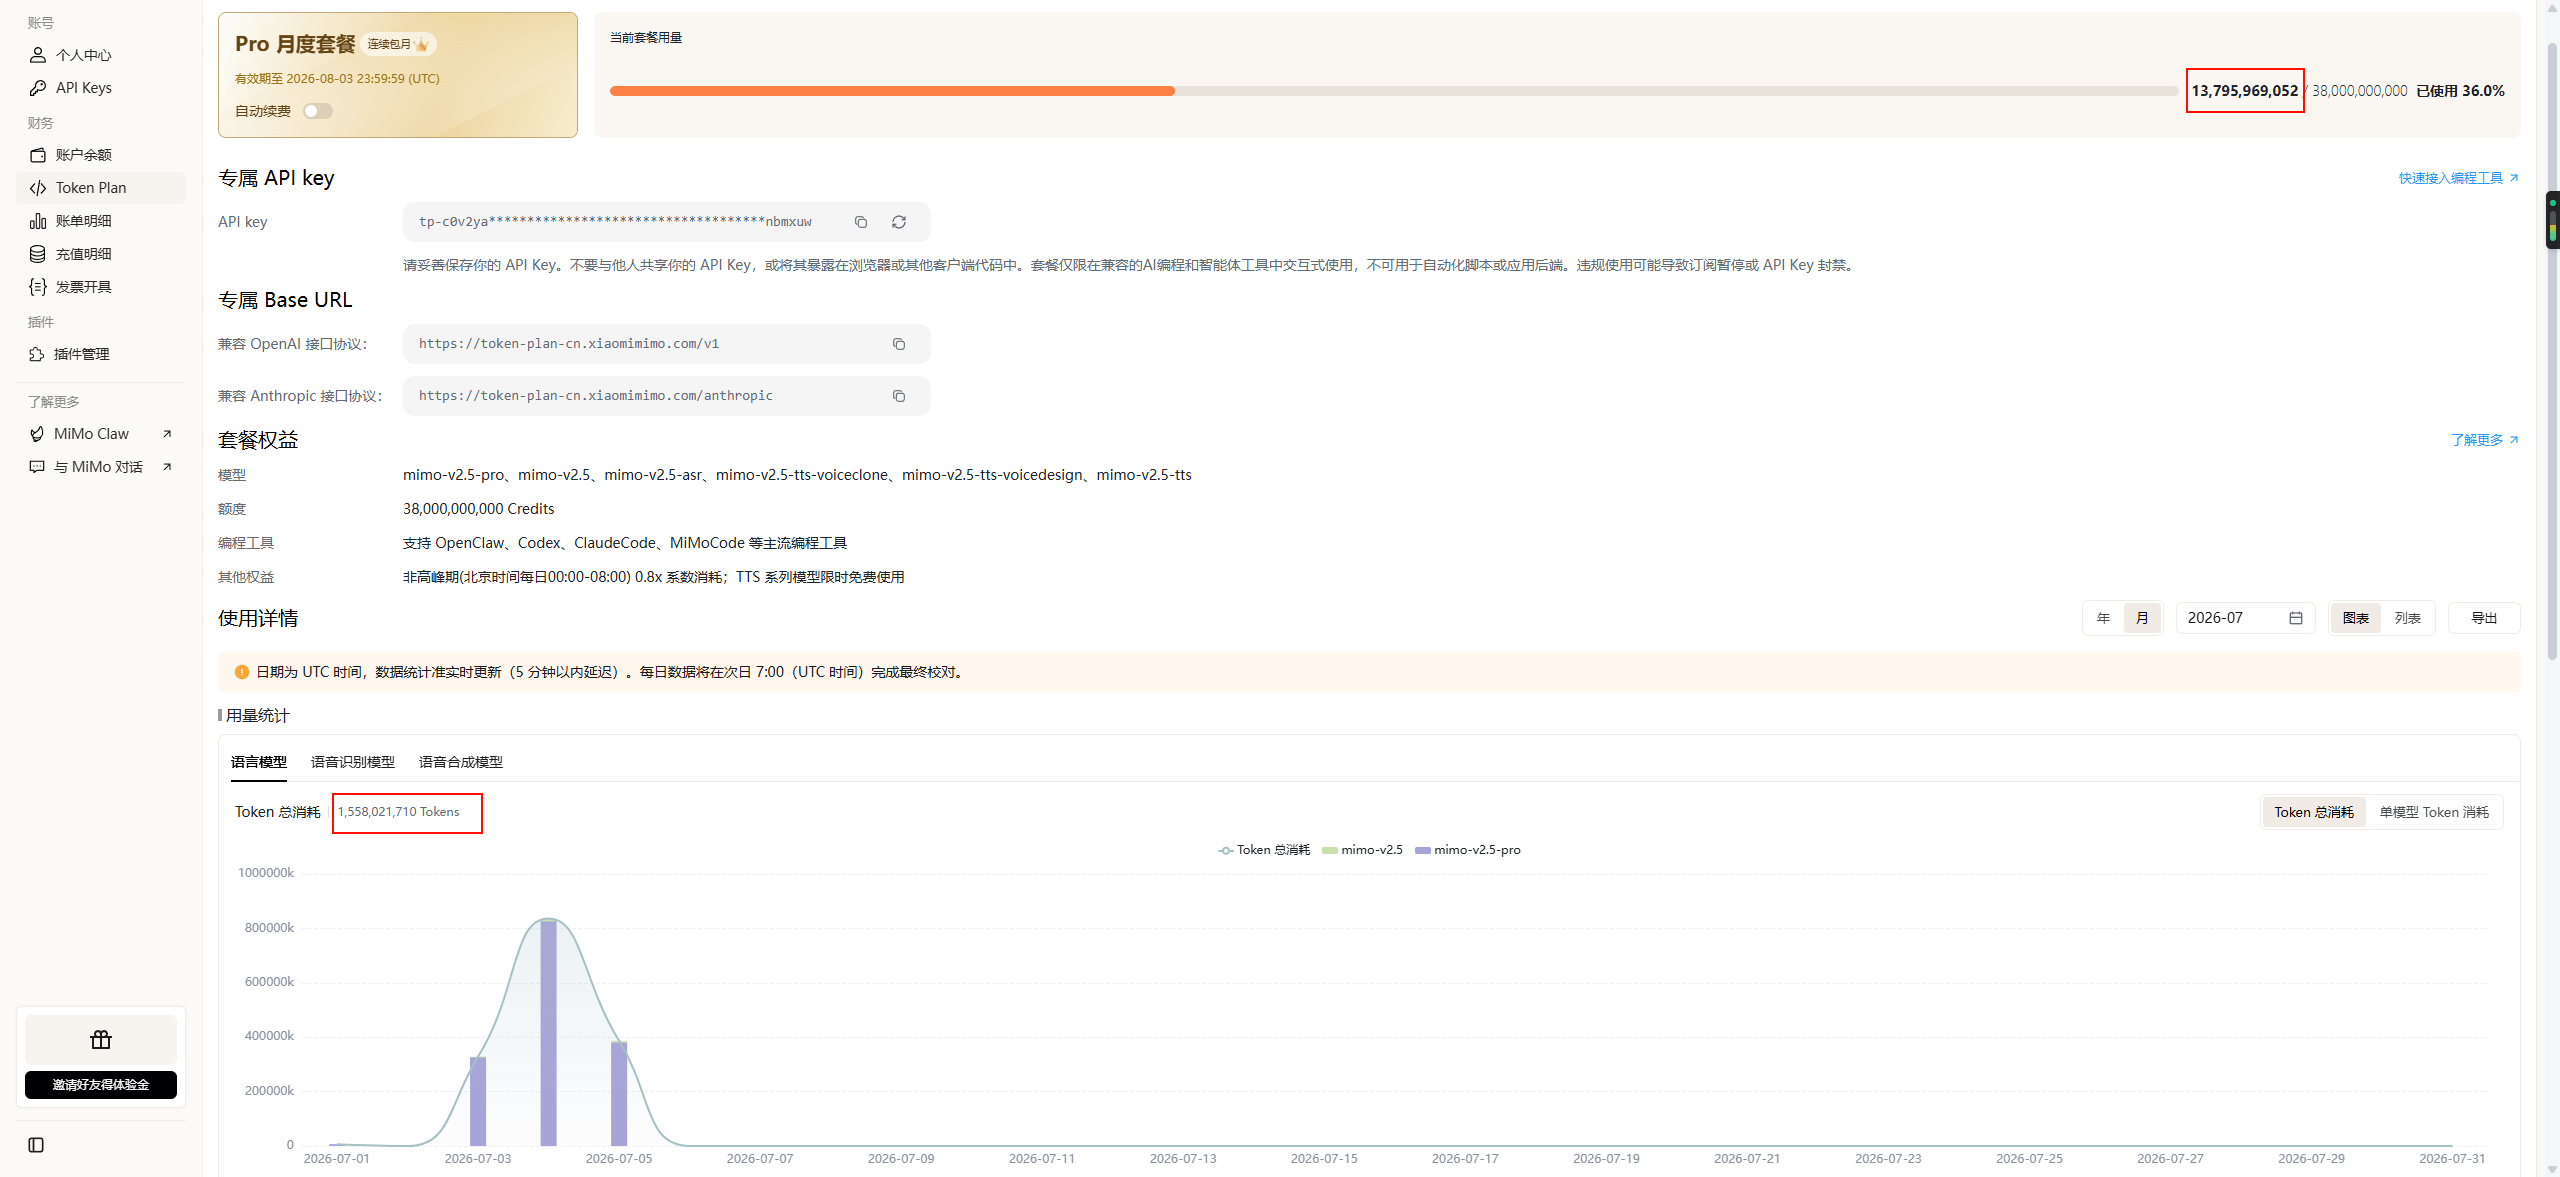
实验结束时
本次实验消耗超过 130 亿 Credits,折算超过 15 亿 Token。原始报告
下面嵌入原始 HTML 报告快照。它包含完整图表、任务矩阵、来源证据、raw vs analysis sensitivity、failed checks 和 LLM judge overlay。下一步
- 评分指标与双 Agent 评测 - 理解
pass@k、pass^k、rubric 和 LLM judge。 - 读取评估报告 - 学会从 summary、report JSON 和 failed checks 定位问题。
- Eval harness - 理解评估如何运行、如何收集 stream-json 证据。