读报告时先看这些
阅读报告时按以下顺序检查:发布判断不能只看
weighted_score。
一次运行是否通过由 checks_failed 决定。
rubric、pass@k 和 pass^k 用于诊断与对比。评分指标
rubric 和 pass 指标用于诊断和比较。通过条件是
checks_failed == []。大多数失败来自任务校验器,但 profile 也会把必需 Skill 未触发等工作流契约问题写入 checks_failed。证据从哪里来
Comet eval 从 Claude CLI 的 stream-json、任务产物、校验器结果和 Runtime 状态中收集运行证据。 单轮评测会在 Docker 里的任务目录直接运行被测 Agent:stdout / stderr,再逐行解析 stdout 的 JSONL 事件。
解析器会提取:
result事件里的duration_ms、num_turns、token 和 costtool_use事件里的工具调用Bash命令,作为commands_runWrite/Edit文件路径,作为files_created/files_modifiedSkill调用,作为skills_invoked- 对应的
tool_result输出,挂回原工具调用
Skills invoked、commands_run、tool_calls、files_created、token/cost 等,都是从 Claude CLI 结构化事件流整理出的可观测行为日志。
轨迹和事件流不是一回事
Comet Classic runtime 自己也会写.comet/trajectory*.jsonl,记录状态推进,例如 state_transitioned。这类 trajectory 是恢复能力的证据之一,rubric 会在 recovery_resilience 里检查它是否存在。
但 pass@k / pass^k 不从 trajectory 计算,rubric 的大部分维度也不是只看 trajectory。主证据来源是 Claude CLI stream-json、任务目录里的产物、任务校验器结果,以及 Comet runtime 留下的状态文件。
rubric 评分
rubric 把 Skill 的质量拆成多个维度,每个维度由若干二元(pass/fail)检查项组成,维度分 = 通过项数 / 总项数(0.0–1.0)。每个维度输出一行[RUBRIC] <维度>: <分> - <原因>。
评分方法论(对齐 Galileo、Hebbia、τ-bench 等业界实践):
- 每个维度含 N 个二元检查项
- 维度分 = passed / total(0.0–1.0)
- 加权总分 = Σ(维度分 × 权重) / Σ(权重)
- 权重反映维度对工作流质量的重要性
三套 rubric
eval 内置三套 rubric,对应三种 profile:comet-workflow rubric(10 维)
这一套用于评估经典五阶段工作流。 十个[RUBRIC] 维度分只作诊断参考。
但 profile 仍会做工作流契约检查。
如果没有真实触发 comet、嵌套 Comet 阶段 Skill、OpenSpec 依赖 Skill 或 Superpowers 依赖 Skill,会触发硬失败。
generic rubric(7 维)
评估通用 Skill。和 comet-workflow 不同,它对”必需 Skill 未被调用”会产生硬失败(当require_skill_invocation: true 时),其余维度仅提供诊断信息。
authoring-skill rubric(11 维)
评估/comet-any 生成的 Skill 包。它先继承 generic 的四个共享维度,再加七个包专属检查。缺 SKILL.md、缺 resolved-skills.json、缺 workflow-protocol.json、缺 Engine 文件、缺 authoring-lanes.json、缺 skill-review.md 都会产生硬失败。
加权总分公式
[RUBRIC] <dim>: <score> - <reason>,最后输出一行 [RUBRIC] weighted_score: <分>。
RubricAvg(报告列)
报告里的RubricAvg 列是该次运行所有维度分(含 weighted_score 行)的简单均分(sum/len)。跨多次运行时是各运行均分的均值。它是快速横向对比的汇总,和单 rubric 的 weighted_score(用各自权重)算法不同。
LLM-as-judge 覆盖(可选)
设置BENCH_LLM_JUDGE=1 可启用 LLM-as-judge。
默认情况下,Comet 的最终 weighted_score 来自规则分,而不是 LLM judge。
规则型 rubric 能抓结构信号(文件存在、命令执行),但难以判断产物是否有实质内容。
LLM judge 会让裁判模型读取 workspace artifacts 后重新打分,并输出 [RUBRIC-JUDGE](与规则分 [RUBRIC] 区分)。
该机制是 best-effort:若 judge 失败,会回退到规则分,不影响整次运行。
judge 在宿主机(不在 Docker 内)通过复用 claude CLI 运行,不引入新依赖。但裁判配置和被测 Agent 配置是有意隔离的:启用 BENCH_LLM_JUDGE=1 时,必须显式设置 BENCH_JUDGE_MODEL,不能回退复用主模型的 ANTHROPIC_MODEL。
如果配置了 BENCH_JUDGE_BASE_URL 和 BENCH_JUDGE_AUTH_TOKEN / BENCH_JUDGE_API_KEY,judge 会优先直接调用 Anthropic Messages HTTP(/v1/messages)。没有专用 judge endpoint 时,才回退到宿主机 claude CLI,并在子进程里清除继承来的主 ANTHROPIC_* provider 设置,再把独立裁判配置映射给自己的 CLI 调用:
这样设计是为了避免”同一个模型既当选手又当裁判”:主 Agent 可以继续使用自己的
ANTHROPIC_MODEL、ANTHROPIC_BASE_URL 和 token,judge 必须单独声明模型和 provider。direct HTTP 路径也能避开某些严格 Anthropic 兼容代理不接受 Claude CLI 额外请求参数的问题。若开启了 BENCH_LLM_JUDGE=1 但缺少 BENCH_JUDGE_MODEL,报告会写入:
enabled_and_successful,也不会调用裁判模型。
不同 profile 覆盖的维度不同:
generic/authoring 的三维度评分标准:
judge 收集 workspace 文件时跳过
.git、node_modules、.comet 等目录,单文件上限 3000 字符、总预算 20000 字符,大文件(>50KB)和二进制文件会被跳过,保证 prompt 不失控。裁判必须按 [RUBRIC-JUDGE] <dim>: <score> - <reason> 格式逐行输出,每个 reason ≤25 词并引用具体内容。
pass@k 与 pass^k
这两个指标衡量能力 vs 可靠性,是评估 Skill 能否反复稳定运行的关键。它们基于多次重复运行产生的通过/失败序列计算。定义
其中 n = 总运行数,c = 成功运行数。“成功”= 该次运行任务校验器零失败。
为什么需要两个
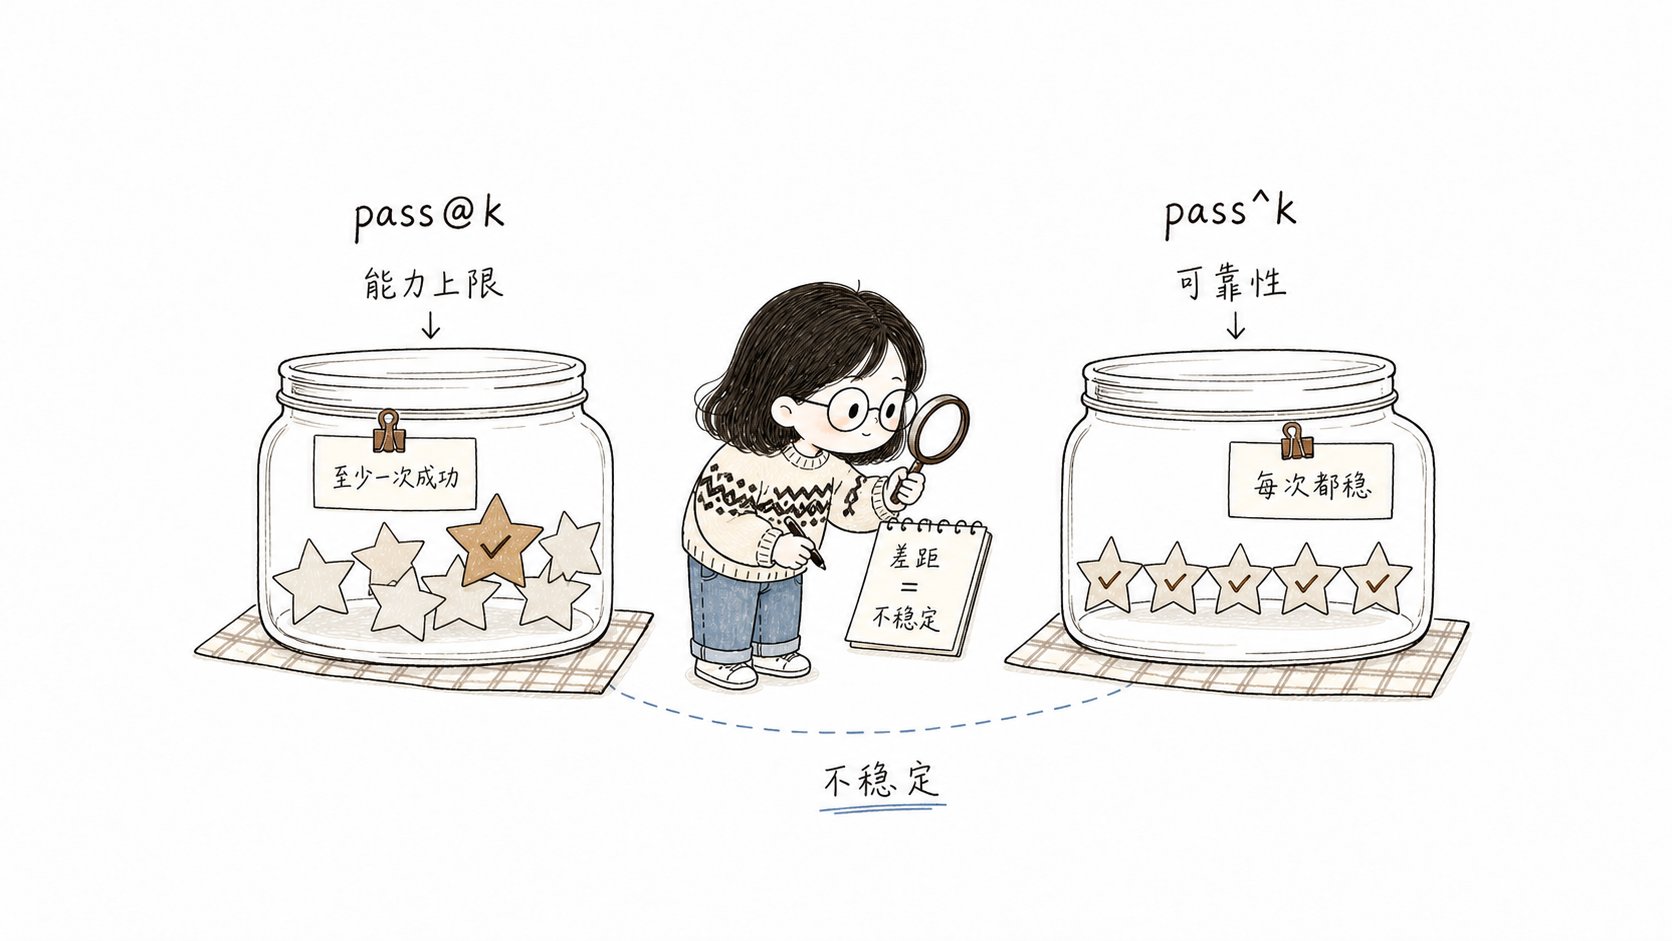
pass@k 看能力上限,pass^k 看可靠性下限,两者差距越大越不稳定
- pass@k 高、pass^k 低:能力够,但不稳定。它代表“能做,但不能保证每次都做对”,对高频使用的 Skill 是危险信号。
- 两者都高:既能做,又能持续做对,才算可信赖。
pass@k − pass^k 的差值,供比较重复运行结果。
怎么得到多次运行
重复运行由 eval harness 内部的 pytest 选项--count N 驱动:它把每个 (task, treatment) 组合重复 N 次,产生 N 个独立的通过/失败结果(comet eval 单次运行只产出 pass@1/pass^1)。对比报告先过滤出 analysis set:明确的环境或运行器本身的问题会被排除,flagged run 仍进入主统计但会被标出。analysis set 里的这 N 个布尔值就是 pass@k/pass^k 的输入。
k 怎么选
报告从{1, 2, 5} 里取不超过实际运行数 n 的 k 值(k 被 clamp 到 n),不足时回退到 [1]。报告列:pass@1 [pass@2 pass@5] 和 pass^1 [pass^2 pass^5]。
出现在哪
pass@k/pass^k 不在summary.md,而在对比报告(comparison_report.md)的 ## pass@k / pass^k — capability vs reliability 章节。它们是信息性的,不是门禁。
双 Agent 自动交互评测
对于多阶段工作流类 Skill(comet-workflow 和 authoring-skill profile),评测由两个 Agent 自动交互完成,不需要真人介入。
两个角色
交互循环
循环最多max_turns 次外层往返(comet-workflow 常见为 12 次,authoring-skill 常见为 8 次),命中”完成”(archive complete / workflow complete / all 5 phases 等)则提前结束。
每一轮被测 Agent 都用 --output-format stream-json --verbose 运行。loop 驱动只把每轮被测 Agent 的 stream-json stdout 拼接起来给 harness 解析。用户模拟 Agent 的一次性回复不会进入主事件流。因此,事件统计只反映 subject Agent 的可观测行为。
max_turns 不是被测 Agent 内部真实工作轮数,也不是工具调用次数。一次外层往返指:被测 Agent 跑到决策点,用户模拟 Agent 回复,然后被测 Agent 用 —resume 继续。同一次往返内部仍可能包含多条 assistant 消息、工具调用和文件操作。决策点检测
被测 Agent 的输出文本匹配这些信号就判定为决策点(不区分大小写):--decision-pattern。
用户模拟 Agent 的指令
模拟 Agent 收到的是 simulator prompt + 被测 Agent 的最后一条消息,指令要求它:- 收到确认请求时,批准提出的方案/名字/计划
- 需要做选择时,选最合理的默认
- 只在问题对”做什么”真正有歧义时才要求澄清
- 永不拒绝,永远让工作流前进
- 不写代码或文件
COMET_SIMULATOR_PROMPT,generic/authoring 用 GENERIC_SIMULATOR_PROMPT(措辞略简)。模拟回复为空时回退到 "Yes, please proceed with the recommended option."。
自定义模拟器提示词
auto_user 评测的模拟器指令可被覆盖。默认从eval/simulator-instruction.md 读取。这个文件预置了上面几条原则。两种覆盖方式(优先级从高到低):
BENCH_SIMULATOR_PROMPT_FILE 的相对路径从 eval/ 解析,默认值为 simulator-instruction.md,文件存在时才会读取。通过替换该文件,可以测试不同用户行为配置,而不需要修改 harness 代码。
设计目的
工作流类 Skill 会在决策点暂停等用户确认。如果评测只跑单轮,Skill 会卡在第一个决策点。双 Agent 循环让评测自动跑完整条工作流(open→…→archive),并由用户模拟 Agent 生成合理、能推动流程的决策点输入。这样测出来的 rubric 分和 pass/fail 才反映真实使用场景。单轮 vs 多轮
genericprofile(interaction.mode: none):单轮,被测 Agent 一次性跑完(适合不需交互的冒烟任务)。comet-workflow/authoring-skillprofile(interaction.mode: auto_user):多轮,启用双 Agent 循环。
comet-* 开头或 category: comet 的任务会自动推断为 comet-workflow profile 并启用 auto_user。
评测的三个轴:treatment × task × reps
一次评测是三个轴的笛卡尔积:treatment 实现 A/B 对比
同一任务跑多个 treatment,就能测出 Comet Skill 的边际效果:
对比报告(
compare_baselines.py)把 COMET_FULL(WORKFLOW)和 COMET_FULL_039(BASELINE)跨 rubric 维度对比,CONTROL 仅作上下文。
指标怎么进报告
详见读取评估报告。
下一步
- 读取评估报告 — 报告结构和失败归因
- Eval harness — collect/run 内部机制和环境变量
- 评估系统概览 — eval 在发布流程中的位置
- comet eval 命令 — 完整选项参考