comet eval 时,CLI 默认使用当前 @rpamis/comet 包中的 eval/。
只有在你开发 Comet 源码或需要自定义 harness 时,才用 --project <repository-root> 指向仓库里的 eval/。
入口路径、任务发现、profile 选择、report config 和 quick smoke 都由 comet eval 统一处理,不需要手工拼 pytest 参数。
harness 定位与故障边界
CLI 会先检查 eval 根目录(pyproject.toml 与任务入口),再检查 uv。
哪个环节失败,就对应哪个问题域:
npm 用户不需要另外 clone Comet 仓库来获得 harness。包版本与 harness 版本保持一致。
harness 目录结构
它封装了什么
comet eval 在内部做这几件事:
- 固定从
<project>/eval根目录启动 harness(用uv run) - 把
--manifest或--skill-path转换成 pytest 参数 - 选择默认 profile(
generic)和 task。没有 manifest 时按 Skill 快照自动生成并缓存受限任务 - 按需生成临时 report config(
--html时) - 打印一组执行信息,便于定位报告
--suite 调用:
comet eval 会替你组装。
collect 和 run
comet eval 是单入口命令,通过 --collect 区分两个阶段:
两者共用同一套参数构建逻辑。
区别只有一处:collect 增加
--collect-only,真实运行增加 -v。
--suite local|langsmith|langfuse 用来切换套件入口。
--report-config、--html、--quick 用来控制真实评估路径。
skill-path 模式(默认入口)
传一个本地 Skill 目录或SKILL.md 时,comet eval 走 skill-path,不需要 comet/eval.yaml:
--quick 会固定使用 generic-skill-smoke 冒烟任务。
--skill-name 默认从目录名推断,也可以用 --task 指定任务,或用 --profile 覆盖 profile。
manifest 模式(评估 /comet-any 完整包)
--manifest 适合 /comet-any 生成物,或任何带 comet/eval.yaml 的 Skill 包:
/comet-any 自动生成,而不是手写。
它包含目标 Skill、profile、推荐任务、预期产物和交互配置。
Engine-enabled 生成物默认使用 authoring-skill profile 与 authoring-skill-smoke quick eval。
这条路径的结果才是发布 readiness 的有效证据。
skill-path 的 generic-skill-smoke 只用于早期验证,不作为发布证据。
generated manifest 的 draft hash
当 manifest 的metadata.draftHash 为 <current-bundle-hash> 时,CLI 会定位上层 bundle.yaml 并计算当前 draft hash。
随后,它会在系统临时目录写入一份运行时 manifest。
Skill source 会解析为稳定绝对路径。
评估结束后,临时目录会自动清理。
原 manifest 和 Bundle 不会被修改。占位值只适用于仍位于 Bundle draft 内的 generated manifest。离开 Bundle 后应使用具体、可验证的 draft hash。
执行信息
comet eval 在运行前会先打印一组执行信息,让你能定位报告和排查问题:
Eval root:实际从哪个eval/根目录启动Mode:collect或runTarget:当前评估的是 manifest 还是本地 Skill 目录Experiment:本次实验 idProfile:本次评估使用的 profileTask:本次评估任务Report path:报告位置Report config:启用--html时使用的临时报告配置
run 模式还会额外提示:失败归因会被记录到生成的 eval summary 里,按 harness、workflow、task、model 四个桶分类。
报告在哪里、长什么样
Experiment ID
实际落盘的 experiment id 格式是<experiment_name>_<YYYYMMDD_HHMMSS>,例如 comet_fix_median_20260620_143000。experiment name 来自第一个参数化测试的 task name(- 转 _)。
报告目录:
summary.md 包含
- 头部:Experiment ID、开始/完成时间。
- Results 表:每个 treatment 一行,列含 Checks、Turns、Duration、Tools、Tokens、Cost、RubricAvg。
- Summary:总运行数、checks 通过 X/Y(百分比)。
- Treatment Details:每个 treatment 每次运行的详细 metrics、skills invoked、scripts used、通过和失败的 check 列表。
每次运行的 report.json
字段包括:passed、checks_passed[]、checks_failed[]、events_summary(duration、turns、tool_calls、tokens、cost、files_created、skills_invoked、failure_attribution)。
一次评估内部:Docker 隔离 + 双 Agent + rubric
理解这一段能帮你判断评估结果是否可信。comet eval ... --html 内部按 treatment × task × reps 跑,每次运行:
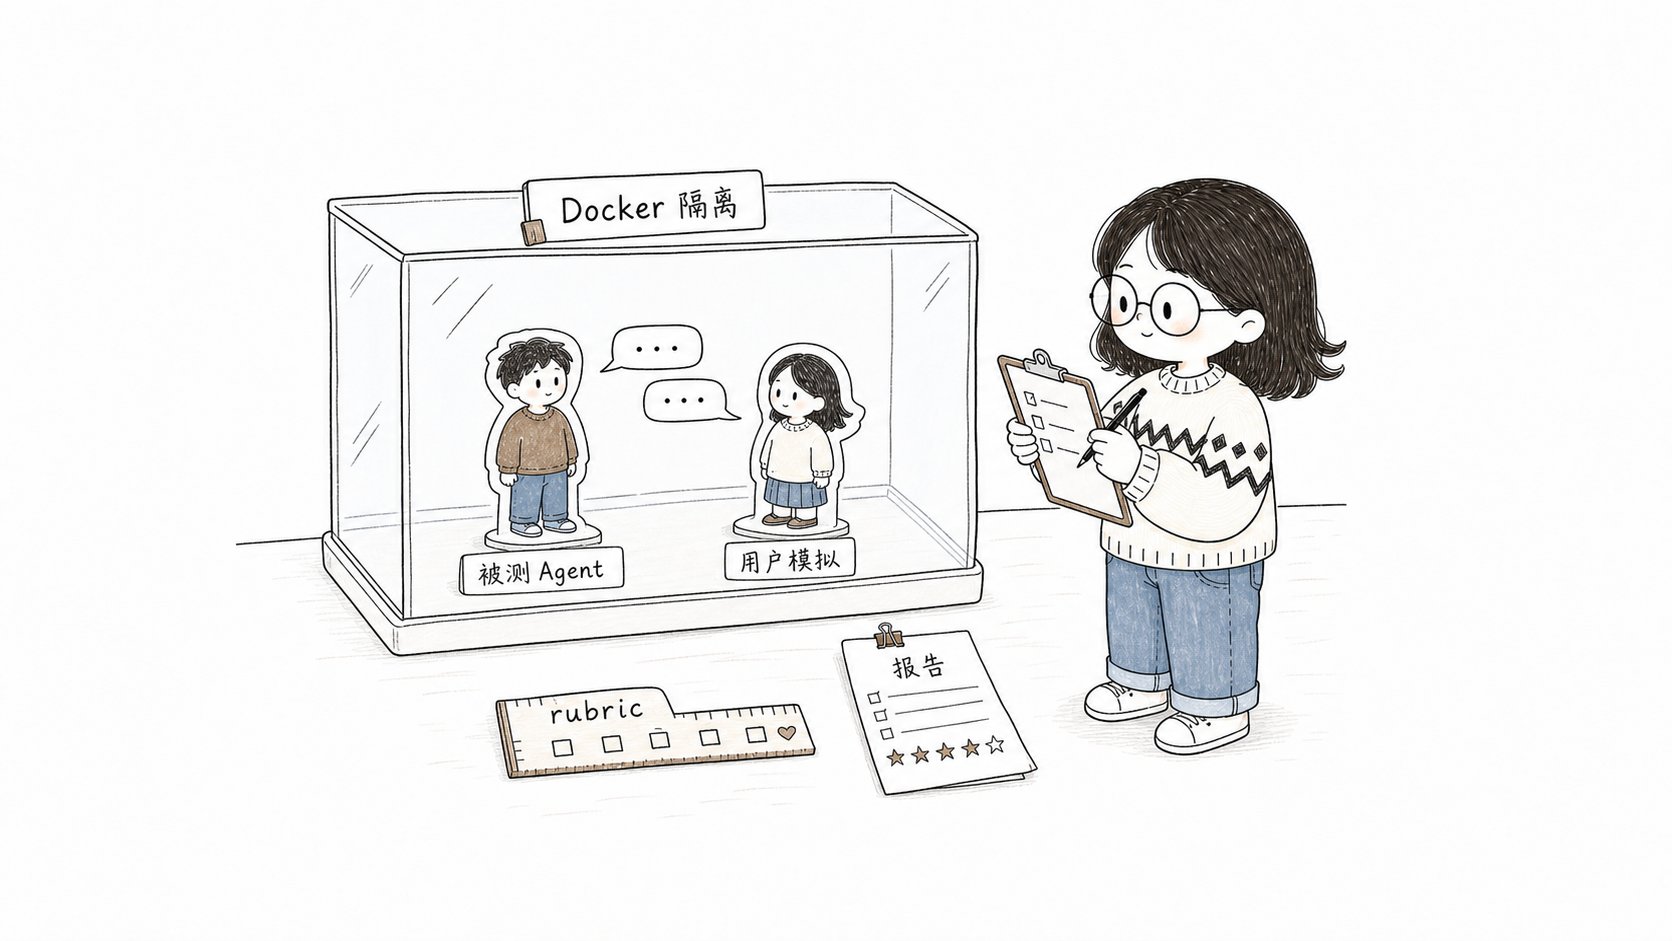
一次真实评估会在隔离环境里运行 Agent 互动,再用校验器和 rubric 记录证据
关键点:- 模型在 Docker 容器里运行,和你的工作目录隔离。
- 双 Agent 循环(
auto_user模式):被测 Agent 运行被测 Skill。每个决策点由用户模拟 Agent回复(批准合理方案、选择默认、推动流程前进,不拒绝、不写代码)。被测 Agent 通过--resume续接同一会话,最多进行max_turns次外层往返(comet-workflow 常用 12 次,authoring-skill 常用 8 次),命中”完成”则提前结束。这里的max_turns不是被测 Agent 的内部消息数或工具调用数。该机制的目标是让多阶段工作流可以自动跑完整条链。完整循环和决策点检测见评分指标与双 Agent 评测。 - rubric 评分在校验器之后跑,把结果作为
[RUBRIC]信息性检查追加(comet-workflow rubric 永不产生硬失败。generic/authoring 对特定缺失项产生硬失败)。 - 真正的通过/失败由任务校验器(expected artifacts 存在 + test_scripts 通过)决定,rubric 分和 pass@k 是诊断信息。
报告输出配置
报告输出由ReportOutputConfig 控制,优先级:
--report-config <path>(JSON 或 YAML)COMET_EVAL_REPORT_CONFIG环境变量- 默认(只 markdown)
--html 等价于 {"markdown": true, "html": true},会写一个临时文件传给 pytest。
失败归因
报告会帮助区分失败来源。归因逻辑(attribution.py)按这个顺序判断每个失败的 check:
这个归因用于判断下一步应该修 Skill、修 eval 配置,还是重跑环境。详见读取评估报告。
环境变量参考
LangSmith suite 额外需要
LANGSMITH_API_KEY、LANGSMITH_TRACING=true、TRACE_TO_LANGSMITH=true。
用户入口是 comet eval <target> --suite langsmith。
不需要手工进入 eval/langsmith/ 执行 pytest。
Langfuse suite 需要 LANGFUSE_PUBLIC_KEY 和 LANGFUSE_SECRET_KEY。
用户入口是 comet eval <target> --suite langfuse。
--collect --suite langfuse 不初始化 SDK、不联网,也不会下载插件。
用 Anthropic 兼容代理认证
当ANTHROPIC_API_KEY 未设置时,Docker 内的 claude 改用 Anthropic 兼容代理(BigModel / mimo / OpenRouter 等)认证。需要的变量:
这些变量在自动生成的用户级
.env 模板里都有占位项。普通用户编辑
%USERPROFILE%\.comet\eval\\.env / ~/.comet/eval/.env 即可。源码维护者使用
--project 时,才需要在对应源码 checkout 中调试 harness 的 eval/.env。
自定义用户模拟器提示词
auto_user 模式评测里,用户模拟 Agent 的指令由一个提示词文件驱动。默认读 eval/simulator-instruction.md:
BENCH_SIMULATOR_PROMPT_FILE 指向它:
eval/ 解析。文件存在才会被读取。命令行 --simulator-prompt "..." 的优先级最高,会覆盖文件内容。详见评分指标与双 Agent 评测 · 用户模拟 Agent 的指令。
不要把 harness 和 runtime check 混淆
comet eval 和 comet skill check 名字接近,但用途不同:
comet eval:评估一个 Skill 包或comet/eval.yaml,回答”这个 Skill 作为产品能力能不能通过评估”。comet skill check:检查某次 Skill 运行是否缺 artifact 或状态,回答”这次运行是否完整”。
下一步
- 评分指标与双 Agent 评测 — rubric 维度细则、pass@k/pass^k、双 Agent 交互循环
- 读取评估报告 — 学会看懂报告信号和失败归因
- comet eval 命令 — 完整选项和子命令参考
- 评估系统概览 — eval 在流程中的位置和 eval.yaml 格式